南京邮电大学“视在必行”团队: 从看见目标到理解道路风险
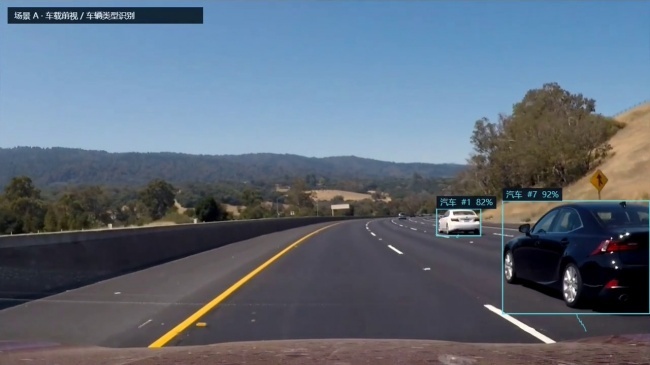
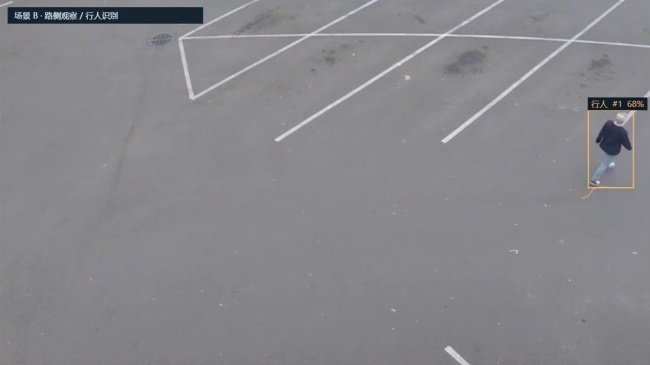
在“视在必行”已有的实景展示中,车载前视画面与路侧片段接续播放,目标框标出画面中的车辆和行人,工作台同步呈现类别及逐目标结果。项目来自南京邮电大学物联网学院,由唐礼昊担任负责人、孙进老师担任指导老师。七人团队以软件算法为主,将这一阶段的工作作为研究入口:先把可见目标的识别和结果检查做起来,再逐步研究动态目标与道路风险之间的关系。
目前,实景工作台使用已有目标检测模型对视频进行处理,能够显示人、汽车、自行车等类别。展示素材来自公开的车载和路侧视频,并非团队自行开展的道路采集。现有38秒实景展示由24秒车载前视、7秒行人片段和7秒人车混行片段组成;工作台支持类别筛选、置信度过滤、原画对照和进度跳转,便于观察不同画面中的识别结果。
在固定示例之外,用户也可以上传新视频进行分析。项目保留了检测输出及处理记录,平台还提供人工补充标注和导出功能。这样,观察者发现遗漏时可以回到对应画面,区分模型输出与人工修改,而不是只查看一段已经剪辑好的效果视频。对于后续研究,这类记录有助于整理典型场景,也为分析检测失误提供了可追溯的材料。
比识别可见目标更难的,是处理暂时看不见的区域。大型车辆、建筑转角或路侧设施可能挡住行人,等到目标进入相机视野,留给车辆反应的空间已经变小。项目在仿真场景中将这类区域作为未知风险进行表达,并通过限速和制动策略展示应对思路。普通摄像头无法穿透实体遮挡,因此当前原型没有把被遮住的行人包装成已经识别到的目标。
对已经进入画面的目标,原型通过连续帧中的位置变化形成轨迹,并以简化运动假设展示短时外推。真实视频中的轨迹位于图像坐标系,能够辅助观察目标移动方向,但尚不能直接给出准确的物理距离或碰撞概率。仿真环境则使用已知空间坐标研究路径与目标运动的关系,两者分别承担观察和策略验证任务,避免将画面上的一条线直接等同于车辆的实际安全能力。
为了让道路关系更容易被理解,团队还制作了点云动态素材。汽车第一视角、侧面和俯视画面展示了扫描点的积累过程,新增的绿色导航带与方向箭头则呈现预设的绕障路线。观众可以同时看到障碍物所在位置、车辆已经行驶的轨迹以及前方路线的变化。这些合成画面用于解释问题和交流方案,真实识别效果仍应回到实景视频及其检测记录中判断。
从目标识别走向风险分析,项目需要进一步面对断轨、目标突然转向和长时间遮挡等情况。现有原型尚未实现人物意图预测网络,也没有形成遮挡后目标感知的实车验证。下一阶段可在可见性变化、识别质量和运动信息之间建立更严谨的联系,为动态特征筛选及定位可靠性研究准备依据。把“看见了什么”与“还有什么不知道”表达清楚,是这套原型当前能够提供的研究价值。(合肥汇思)
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)



