



景区摄像头能拍到游客,却很难判断游客在做什么、是否需要帮助。这是智慧景区建设中一个长期存在的问题。
绍兴大学学生团队研发的一套视频分析系统,试图用跨模态技术回应这个问题:让画面信息直接进入大模型的理解环节,而不是先转成一段文字。
传统视频分析主要依靠目标检测、行为识别,回答的是“有没有人”“人在哪里”“动作是什么”。但在景区,游客行为往往连续而复杂。一名游客靠近危险区域,单帧画面只能说明他站在那里,说明不了风险是否正在形成。
换句话说,景区需要的不只是“识别”,更是“理解”。
这套系统采用的路线是“小模型快速感知+大模型深度理解”。小模型负责从画面中提取人、位置和动作信息,大模型负责把这些信息放到时间和空间关系里作出判断。
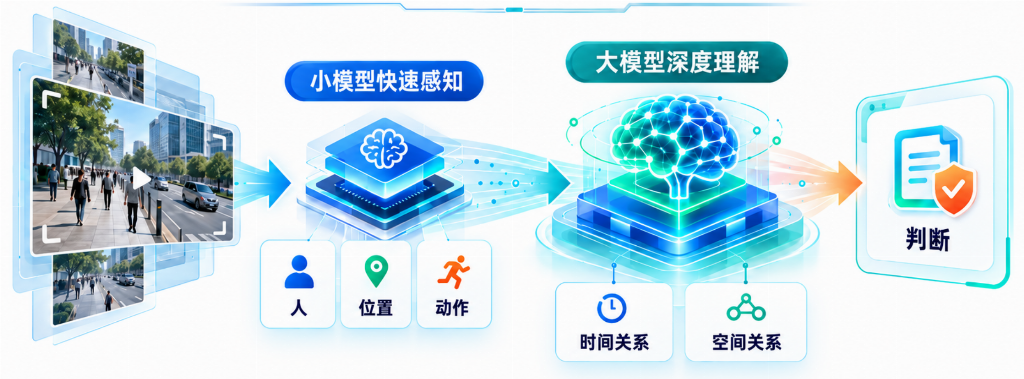
两个环节之间,项目采用Cache-to-Cache跨模态直连技术。团队介绍,这一技术减少了“画面转文字”的中间步骤。
传统做法类似于“先翻译、再理解”,文字描述容易丢失游客之间的位置关系、动作细节和环境信息;信息直连之后,这些内容得以保留。
配合KV Cache时序记忆能力,系统还能跟踪一名游客在一段时间内的变化:停留了多久、朝哪个方向移动、动作是否出现异常。
由此,判断从“异常检测”转向“趋势判断”。当游客持续向临崖区域靠近时,系统提示的不再只是“此处有人”,而是风险正在上升。
在游客服务场景中,同样的方法可以用来判断需求。游客在某个点位反复停留、来回走动,往往意味着他在找路,或者需要帮助。
目前,这套方案已在新昌十九峰、新昌天姥山两处景区开展验证,主要用于识别游客的异常姿态、预判安全风险。
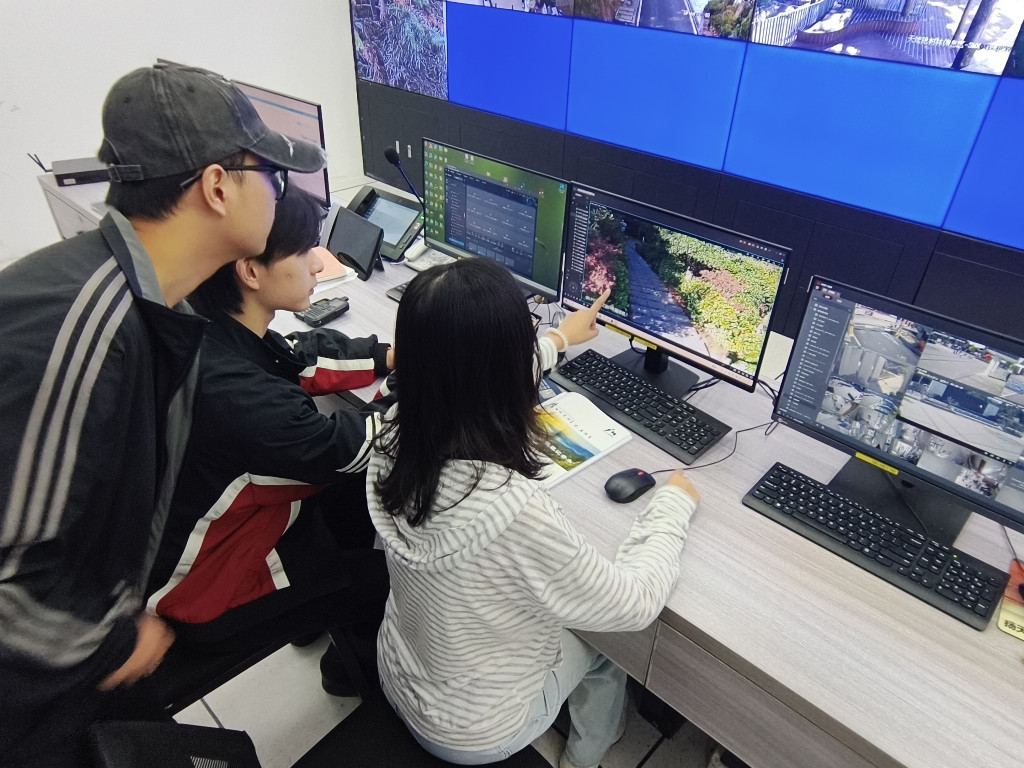
团队表示,从“事后处置”转向“事前预判”,需要经得起不同景区、不同光线条件的检验,下一步将扩大测试范围。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)
频道推荐



