革新语音交互处理逻辑 国产 Speech‑to‑Decision 技术实现技术突破—— 上海爱降临完成近千万元天使轮融资 多项技术成果陆续开源
近日,上海爱降临科技旗下 “AI 降临派” 对外发布 Speech‑to‑Decision 语音决策技术。不同于传统语音 AI 先要把声音转成文字再给出回答的模式,这套技术可以直接解析音频,一次性输出多项业务判断。企业同步完成近千万元天使轮融资,投资方为思脉产融、山海创想。除本次开源 Speech‑to‑Decision 全套成果之外,团队计划在 11 月 11 日前后,对外开源全双工语音大模型,给国内实时语音交互领域增添一套开源技术方案。
产研协同:打通技术从实验室走向产业的链路
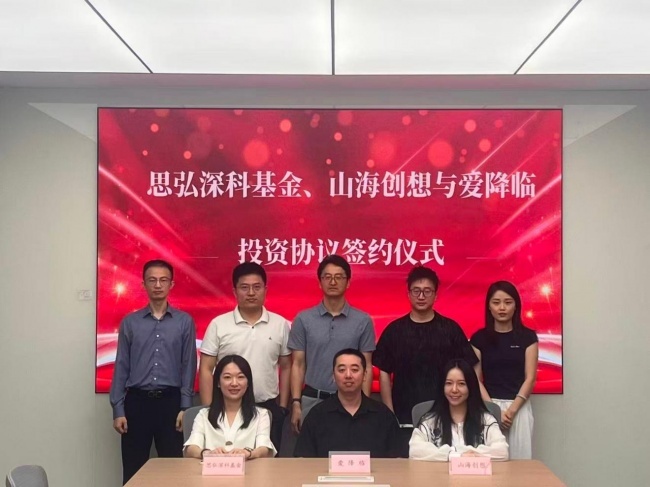
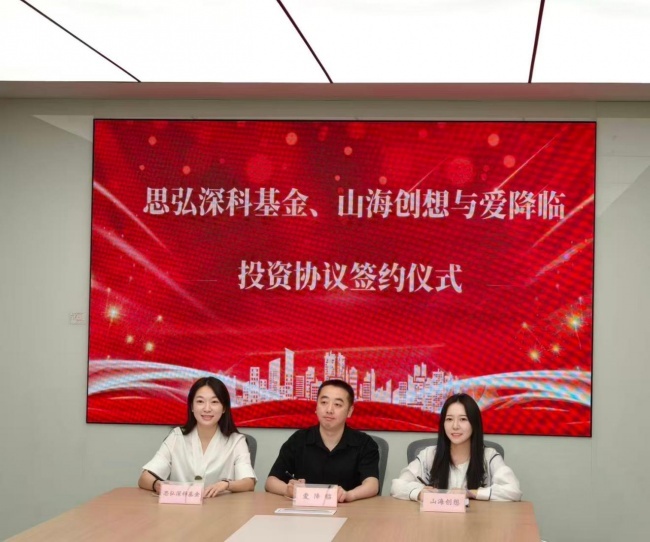
本轮投资机构各有侧重。思脉产融属于硬科技创投基金,联合上海院士深科策源中心做项目孵化,依托院士专家资源,帮助项目打磨技术路线、对接产业资源。山海创想手握万卡级算力集群,能够提供算力调度、模型部署、私有化 AI 建设等服务,支撑政企、医疗、高校的数字化项目。
两方资源配合,完整覆盖从模型训练调优到业务落地的全流程。不少开源项目都有同样的困境:技术代码完成度很高,但缺少真实落地场景,很难转化成可用产品。本次合作,正是希望破解这一现实难题。
上海爱降临方面表示,后续会持续打磨全双工语音交互技术,降低行业使用门槛。依托开源的方式凝聚产学研各方力量,推动国内人工智能产业生态不断完善。
行业缺口:两类前沿 AI 技术难以兼顾音频与可控决策
2026 年 9 月,AI 领域出现两条值得关注的技术方向。TypeSafe 推出的 Jev 模型跳出大模型逐字生成文本的思路,直接输出带概率的结构化判断,该技术一经发布,行业很快出现多个开源复刻版本,但它只能处理文字,接收不了声音信号。
另一边,全双工语音技术快速发展,不少模型已经实现边听边说、支持对话打断。可这类模型的内部判断逻辑处于封闭状态,企业很难按照自身业务规则去干预和控制。
实际语音场景恰恰最需要快速、可控的判断,比如要不要接话、是否允许被打断。一边是会做判断却听不见声音,一边是听得见声音但判断不可控,两者之间形成明显的技术空白,Speech‑to‑Decision 正是针对这个空白研发而来。
技术实践:跳过文字转写,音频直接输出多维度判断
按照研发团队介绍,Speech‑to‑Decision 不再强制把语音转为文字。音频输入之后直接运算,一次计算就可以同时完成上百项判断,包括识别对话状态、分配工具调用、分辨说话人特征等工作。
传统流程要依次完成等待静音确认、语音转写、生成首句回复,这三步耗时最久。新技术将其合并为单次运算,理想状态下,可以把用户说完话到机器响应的时延压缩至 100 毫秒左右,在提速的同时,还能够降低整体部署成本。实测数据显示,该技术依靠语音答题,效果可以达到文本答题水平的 98%,还能捕捉到性别这类文字转写会丢失的声学信息。
这项技术并不是单纯在实验室推演得出。“AI 降临派” 旗下车载智能助手 Dimi 已经装车运行,团队统计约 1500 台设备产生的近 48 万轮汇总对话数据后,看到不少现存痛点。数据显示,88% 的对话需要判断是否调用工具,53% 的对话要识别用户意图,但传统方式需要大模型处理上万字符上下文再逐字输出;语音转写接近一半时间消耗在逐字生成环节;约 8% 的对话因为误判对话结束,造成算力白白浪费,车载环境下用户等待回复的中位时延达到 1.3 秒,体验并不理想。
针对以上问题,这套技术确定了清晰实现路径:跳过逐字转写,把业务需求转化为选择判断任务,实现一步输出结果;支持上百个任务打包批量运算;融合语音模型多层特征,保留声音本身携带的信息。整套架构开放灵活,各类语音、大模型组件都可以替换,支持私有化部署,保障企业语音数据本地留存。
成果输出:学术开源与产品落地同步推进
目前,该技术相关学术论文已经投递语音领域顶会 IEEE ICASSP 2027,模型权重、训练方法以及评测基准同步对外开源。团队还将前往悉尼参加 Interspeech 2026 国际语音会议,和海内外学界、产业界交流研发与落地经验。
项目也已经规划好后续产品节点。10 月 10 日上线商用全双工语音接口,成本不到行业平均水平的一半;10 月 15 日开源全双工 Jev 对话管线,支持组件替换、接入私有知识库、私有化部署,方便企业做二次开发。团队也面向汽车、客服、智能硬件企业和科研机构开放合作,共同开展技术测试与落地实践。
开源开放是国内人工智能创新的重要路径。Speech‑to‑Decision 把底层技术能力对外共享,面向车载、智能客服、消费硬件、企业质检等场景提供新选择。随着后续成果持续迭代开源,有望进一步降低国内企业开发实时语音交互产品的门槛,推动前沿语音技术落地各行各业,为我国人工智能高质量发展积蓄力量。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)
频道推荐