


9月8日,北京知道创宇旗下开源AI智能体“AiPy”正式发布AI Agent Benchmark(AI智能体实战评测基准),并面向全球开发者开放下载。
在人工智能加速从“会说话”迈向“会办事”的关键节点,这一评测基准的问世,被业内视为衡量AI智能体真实生产力的一把新标尺。与传统大模型评测不同,它不再满足于让模型答对一道题,而是要求智能体在真实的电脑环境中完成一整套工作——读取文件、调用工具、处理海量数据,直至交付可验证的成果。
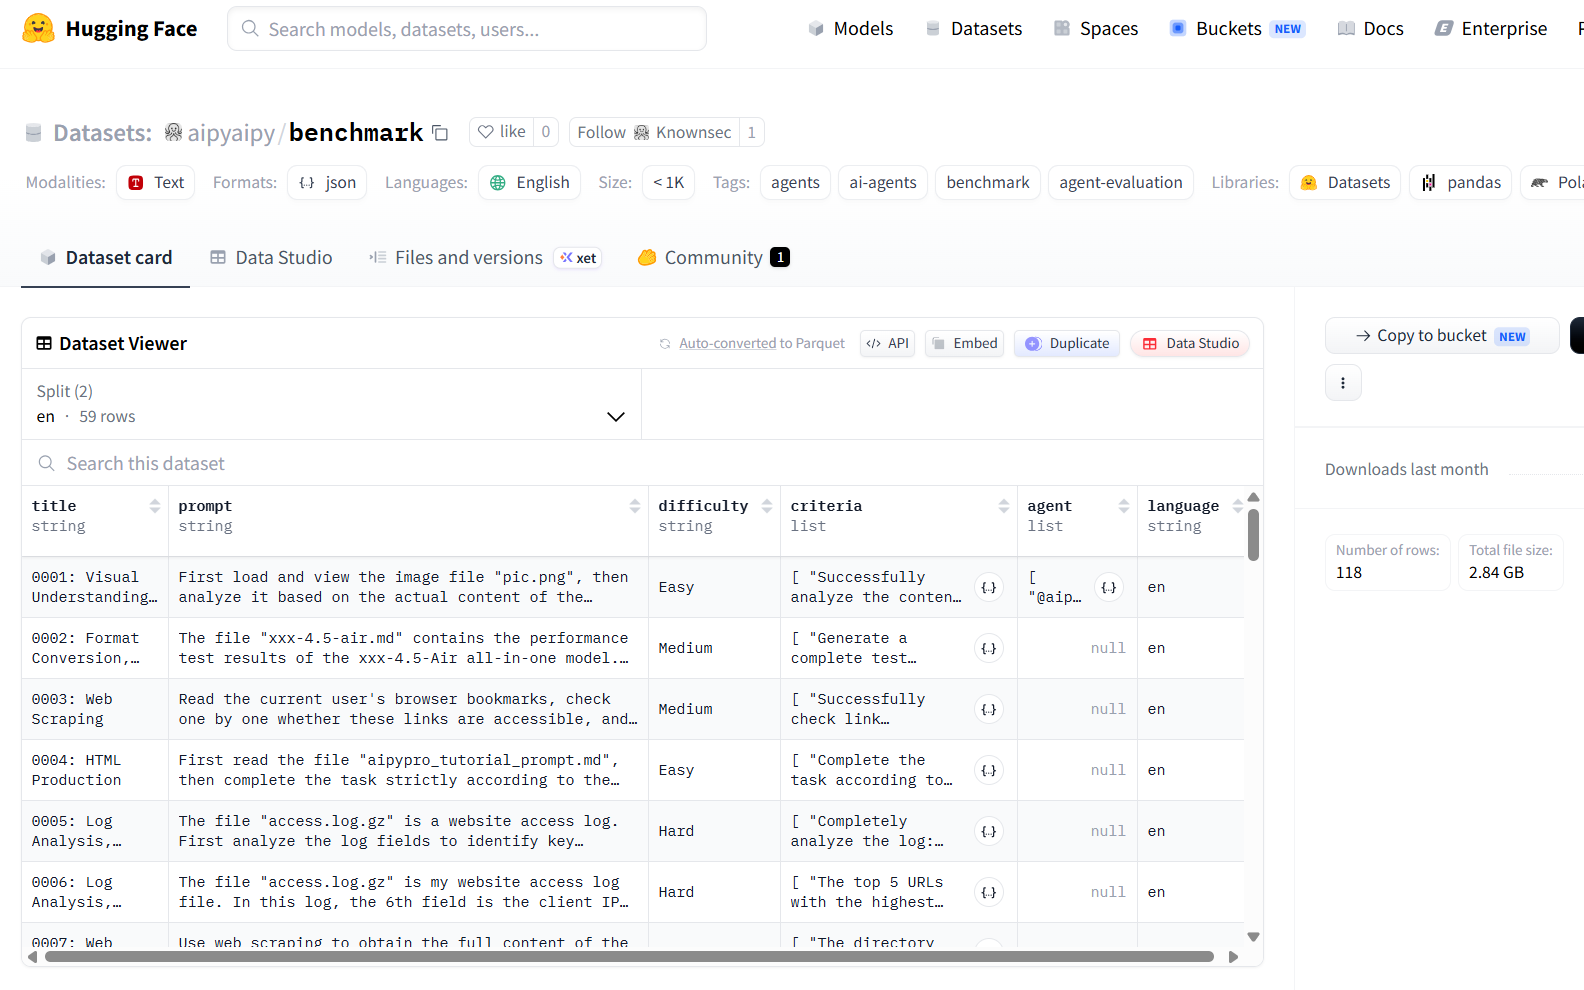
据了解,本次发布的AI Agent Benchmark数据集托管于全球领先的人工智能社区Hugging Face,以宽松的MIT开源协议发布,提供中英双语版本,共收录59项源自真实工作场景的任务。这些任务覆盖数据分析、网络爬取与信息检索、文件与文档处理、编程与软件开发、内容创作、计算机交互、视觉理解、研究推理等八大领域,并按简单、中等、困难三个层级设置难度梯度。
与传统“纸上谈兵”式的问答测试相比,这套基准的每一道题目都力求“真刀真枪”。例如,其中一项任务要求智能体解析包含3170万条记录的网站访问日志,从中识别出URL、IP、UA等关键字段,并最终生成一份排版精美、内容无乱码的HTML分析报告;另一项任务则要求智能体读取用户的浏览器收藏夹,逐一核验链接的有效性,并将失效链接整理成规范的Excel清单。此外,还有加载图片并给出专业分析结论、基于性能测试数据撰写准确完整的报告等任务,全方位考验智能体与真实应用环境深度交互的能力。
值得注意的是,每一项任务都配备了清晰可量化的验收标准,用以判定智能体是否真正“把活干成”,而非仅仅给出一句漂亮的回答。评测方表示,这种设计使得整个评测过程客观、可复现、可追溯,既可用于横向对比不同智能体的能力差异,也可作为研发过程中的回归测试与缺陷分析依据。
这一基准的推出,直指当前AI行业的一个普遍痛点。随着各类智能体产品竞相登场,“我们的Agent比某某强百分之二十”之类的宣称屡见不鲜,但支撑这些说法的评测方法却往往语焉不详。业内人士指出,传统大模型评测多建立在单轮问答、存在标准答案的前提之上,而智能体完成任务需要历经多步骤决策,路径千差万别,仅凭最终结果难以全面反映其真实水平;加之评测数据集若不够透明,还容易滋生数据污染与“刷榜”乱象。正因如此,一套公开、可信的能力标尺,已成为产业健康发展的迫切需求。
有分析认为,爱派AiPy团队选择将评测基准全面开源、交由全行业共同打磨,意在以开放换取公信力——让每一次能力宣称都有据可查、经得起检验。在智能体即将大规模融入办公、金融、医疗等关键场景的前夜,此举也被视为中国开源力量在全球AI评测话语权上的一次有力发声。
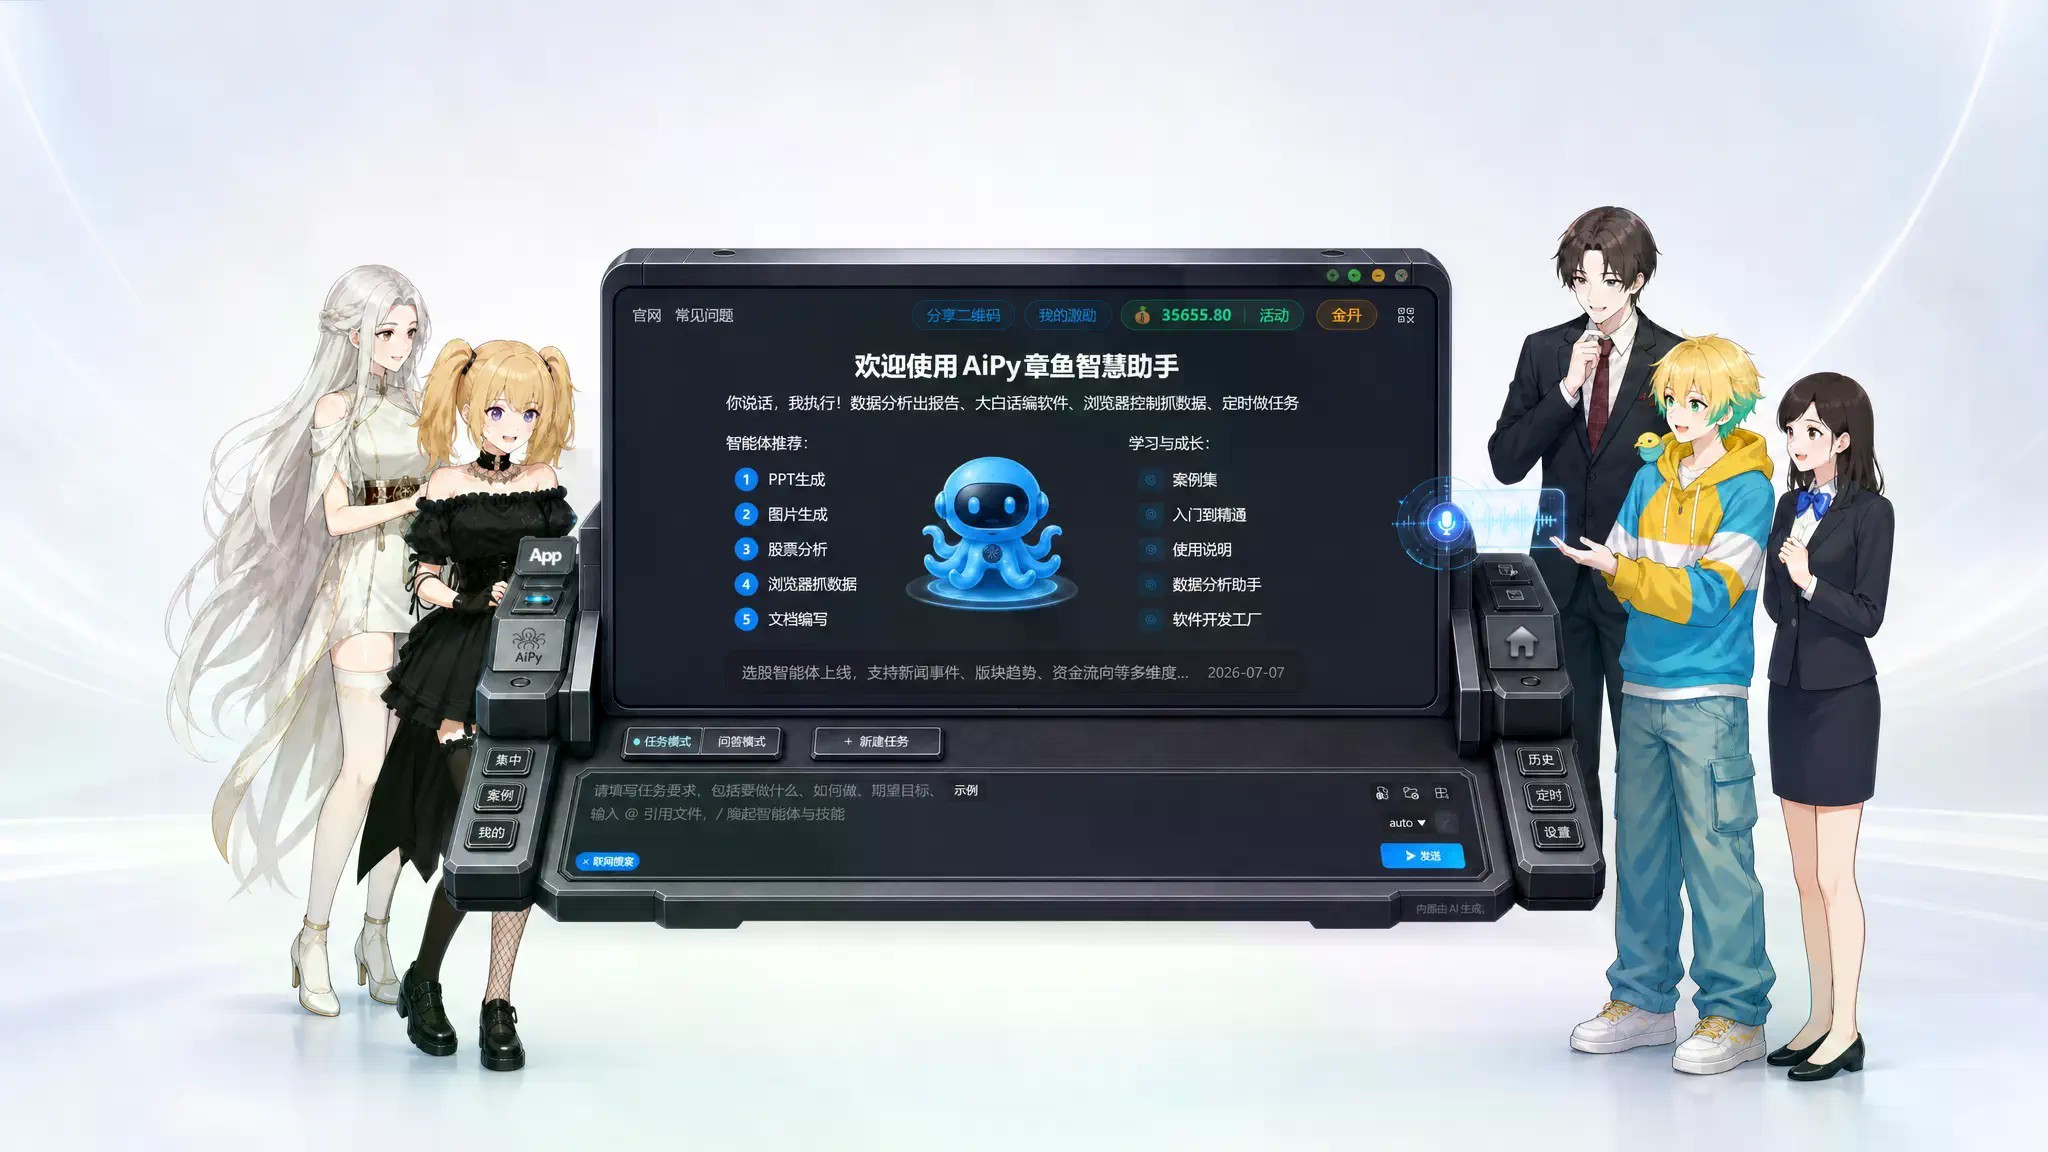
据官方披露,自2025年4月发布以来,AiPy Pro的应用规模持续攀升,日均词元(Token)消耗量已超过100亿,过去一年增长超过100倍;其开源项目在GitHub上获得近3000个Star,累计下载量突破50万次,活跃的开发者社区为这套评测基准的持续演进提供了坚实支撑。
资料显示,爱派AiPy是北京知道创宇推出的开源AI智能体,基于创新的Python-Use范式,将大语言模型与Python执行引擎深度融合,实现从需求解析、任务规划、代码生成到自动执行、动态调优的全链路闭环。该产品免费开源,支持本地化部署与内网运行,数据全程在用户设备上处理,兼顾效率与隐私安全,在数据分析、办公自动化、文档处理、量化研究等场景表现突出。
(免责声明:此文内容为本网站刊发或转载企业宣传资讯,仅代表作者个人观点,与本网无关。仅供读者参考,并请自行核实相关内容。)
频道推荐